Erklärbilder und -videos in Eigenregie: Visualisieren, was keine Kamera zeigt
Wer über Medizin, Technik oder Wissenschaft publiziert, braucht selten ein Foto, sondern die möglichst dynamische Darstellung eines Mechanismus. Aber einen Grafiker zu finden, der dies kompetent als Zeichnung oder Animation umsetzt, ist schwierig und für Einzelne oft auch zu teuer. Doch diese Schwelle ist dank KI-Anwendungen für jedermann gefallen. Was bleibt, sind handwerkliche Fragen: Wie promptet man brauchbar, wie hält man Konsistenz, wie sichert man Faktentreue? Leicht ist davon nichts, am wenigsten das Prompten. Hier folgt ein Praxisbericht aus dem Arbeitsalltag der medizinischen Visualisierung.
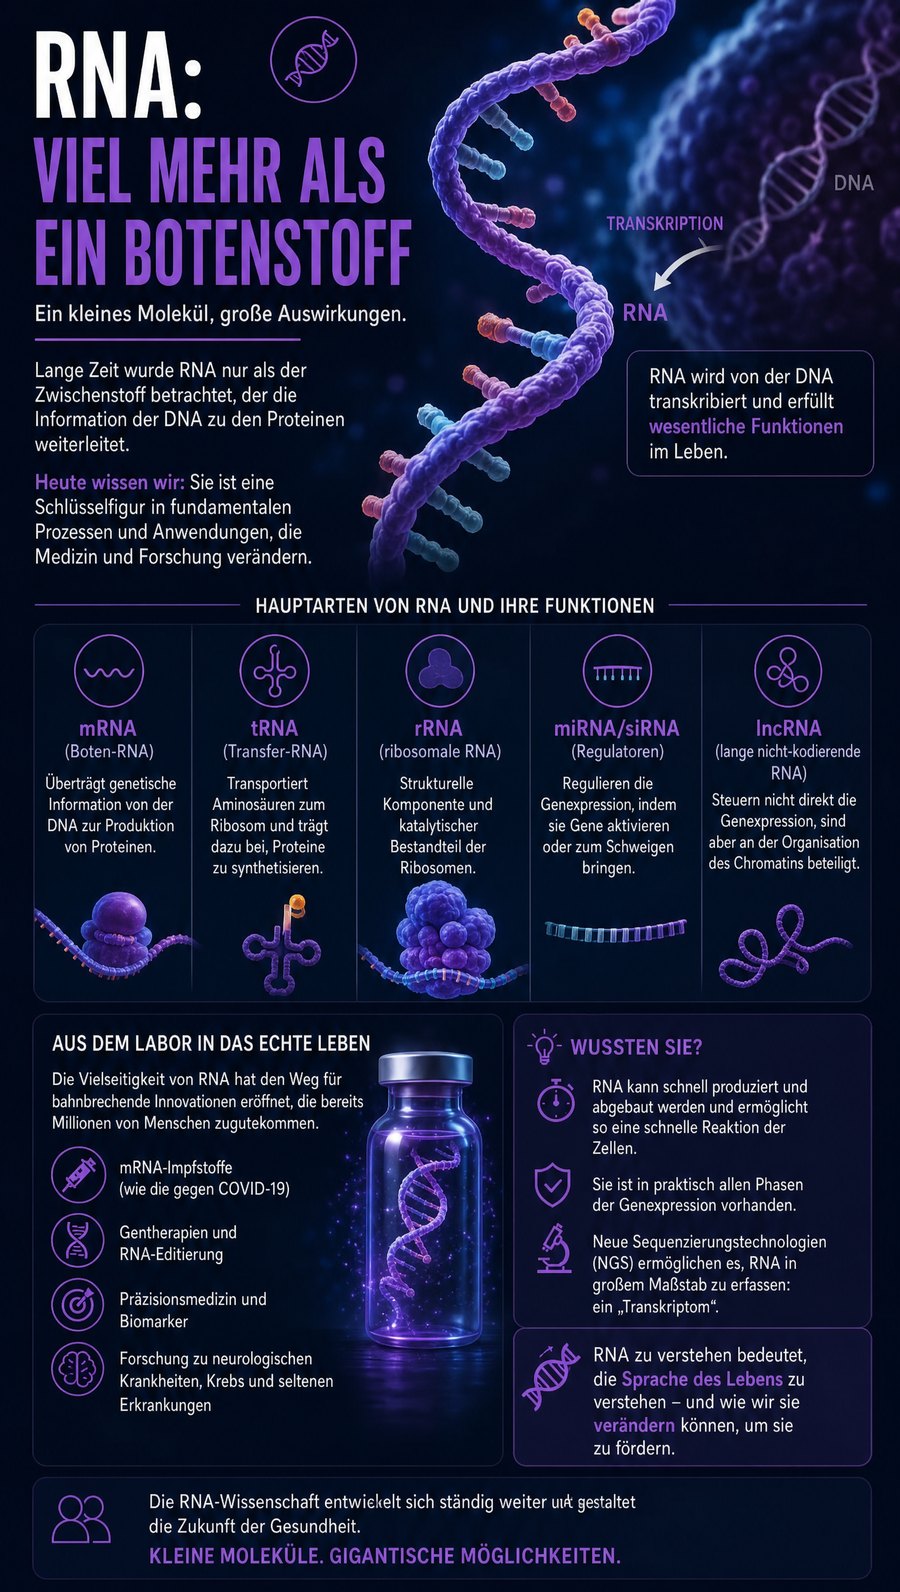
Es gibt bestimmte Prozesse, die man nicht fotografieren kann. Wie ein Wirkstoff an einen Rezeptor bindet. Wie sich eine Wirbelsäule unter Last verformt. Wie ein Sensor im Inneren eines Geräts misst. Wer über solche Themen schreibt, kennt das Problem: Der Text steht, und die passende Darstellung existiert nicht.
Die Auswege waren bisher überschaubar. Eine:n wissenschaftliche:n Illustrator:in beauftragen, was Geld kostet und unter Umständen Wochen dauern kann. Ein Stockarchiv durchsuchen und mit dem leben, was ungefähr passt. Oder eben ohne visuelle Darstellung veröffentlichen.
Doch mittlerweile gibt es ganz andere Ansätze. Ich arbeite seit einigen Jahren mit generativen Bild- und Videomodellen und will hier beschreiben, was davon im journalistischen Alltag wirklich trägt, was nicht, und was es tatsächlich an Zeit kostet. Denn in Anbieterwerbung und in vielen Onlinebeiträgen kursieren Zahlen, die mit meiner Erfahrung wenig zu tun haben.
Realitätscheck: Was funktioniert und was nicht
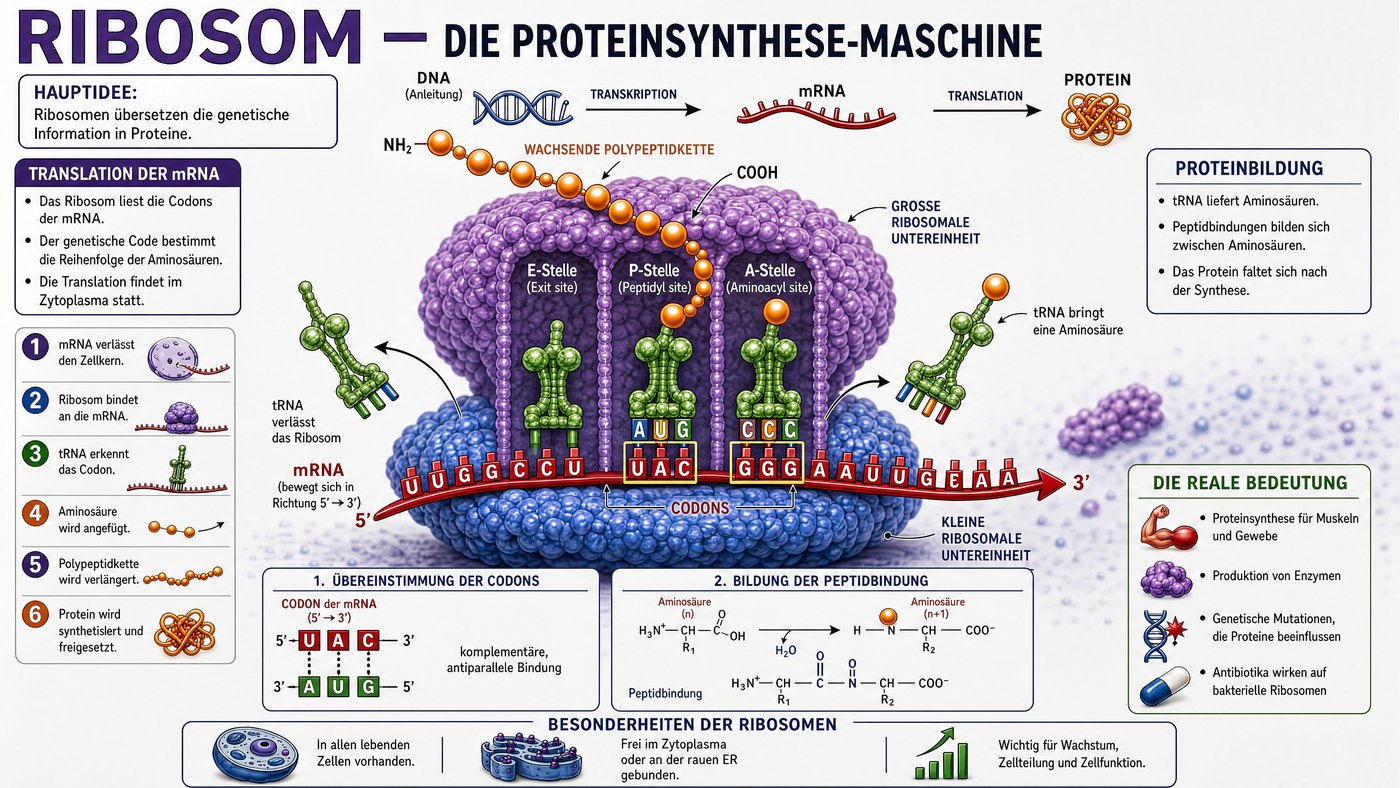
Zuverlässig und korrekt erstellen lassen sich mit Anwendungen der künstlichen Intelligenz (KI) schematische Darstellungen von Abläufen, Bewegungsprinzipien, Vergleichsdarstellungen, Atmosphäre und Kontext. Alles, wo es auf das Prinzip ankommt und nicht auf die millimetergenaue Korrektheit jedes Details. Welche Anwendung sich wofür eignet, zähle ich weiter unten im Einzelnen auf.
Unzuverlässig bleiben die KI-Modelle bei exakter Anatomie, korrekten Beschriftungen im Bild, bei Zahlen und Diagrammen sowie bei seltenen Spezialgeräten. Wer ein Modell bittet, ein Diagramm mit echten Werten zu zeichnen, bekommt eine Zeichnung, die aussieht wie ein Diagramm. Die Zahlen darin sind erfunden. Für Diagramme nehmen Sie weiterhin ein Diagrammwerkzeug. Diese Grenze ist wichtiger, als sie klingt. Sie entscheidet, ob generative Werkzeuge Ihnen Arbeit abnehmen oder Ihnen einen Fehler unterschieben.
Der Weg vom Bild zum Video
Mein Ablauf ist zweistufig – aus gutem Grund.
Zuerst erzeuge ich Standbilder und beurteile sie. Pro Motiv entstehen im Schnitt drei bis fünf Varianten je Modell. Erst wenn ein Bild inhaltlich und gestalterisch sitzt, wird es in einem Videomodell animiert.
Ab hier beginnt der Teil, den man leicht unterschätzt. Die Animation eines Bildes ist keine Fortsetzung des Promptens, sondern Videoarbeit. Man braucht ein Gefühl für Schnittlänge, für Bewegungsführung, dafür, wann eine Kamerafahrt trägt und wann sie nur beschäftigt wirkt. Wer keine Erfahrung mit Bewegtbild hat, steht hier vor einer handwerklichen Herausforderung. Das ist kein Argument gegen den Einstieg, aber ein Argument für realistische Erwartungen: Standbilder sind der schnellere Weg zu brauchbaren Ergebnissen.
Wie viel Aufwand wirklich dahintersteckt
Hier kommen wir zu den Zahlen – und ich halte mich an meine eigenen.
Ein einzelnes Bild oder ein kurzer Clip ist tatsächlich schnell erzeugt. Mit einem guten Prompt, ausreichenden Angaben und passenden Referenzen vergehen Minuten und die Generierung selbst kostet Centbeträge. Wie schnell es geht, hängt allerdings an zwei Dingen: an der eigenen Routine und daran, welche Qualität man anstrebt.
Etwas anderes ist eine fertige Arbeit. Bis eine Erklärgrafik inhaltlich stimmt, gestalterisch sitzt, beschriftet ist und die Korrekturschleifen überstanden hat, vergehen bei mir zwei bis 24 Stunden. Für einen Videoclip von 15 bis 30 Sekunden benötige ich bis zur Fertigstellung einen bis fünf Tage, weil er aus mehreren Einstellungen besteht, die zusammenpassen müssen.
Beide Angaben stimmen und widersprechen sich nicht. Wer eine einzelne Illustration für einen Beitrag anfertigt, ist schnell fertig. Wer eine mehrteilige Erklärstrecke plant, sollte anders rechnen. Das ist immer noch eine andere Größenordnung als eine Auftragsproduktion, die vierstellige Kosten verursacht und Wochen dauert. Aber es ist nicht der Knopfdruck, als der es manchmal verkauft wird.
Ein Beispiel: Für den folgenden Clip habe ich insgesamt einen Tag gebraucht: Zu sehen ist eine Reise ins Innere der Zelle. Der Clip fährt von der Zelle in ein Mitochondrium und von dort bis zur ATP(Adenosintriphosphat)-Synthase heran. Das ist der winzige Motor, der den Energieträger ATP herstellt. Bevor ich die erste Videosequenz erzeugt habe, habe ich für jede dieser Ebenen ein Referenzbild mit Seedream 5.0 generiert. Ohne diese Vorlagen hätte die Zelle in jeder Einstellung etwas anders ausgesehen. Die einzelnen Clips habe ich jeweils aus einem Start- und einem Endbild erzeugt. Zelle (Startbild) – Mitochondrium (Endbild) und so weiter. Die vorgegebene Kameraführung berechnet dann das KI-Modell (in diesem Fall „Kling 3.0“). Die Stimme stammt von ElevenLabs:
Die Werkzeuglandschaft, kurz sortiert
Ich arbeite derzeit mit neun Bild- und fünf Videomodellen. Das klingt nach Sammelleidenschaft, hat aber einen praktischen Grund: Diese KI-Anwendungen haben in unterschiedlichen Bereichen Stärken. Eine liefert saubere technische Schemata, eine andere fotorealistische Szenen, eine dritte brauchbare Typografie im Bild.
Bei den Bildmodellen sind das aktuell unter anderem Midjourney, GPT Image 2, Nano Banana 2, Seedream 5.0 Pro, Recraft V4.1, Grok Imagine, Kling O1, Flux.2 Max und WAN 2.2. Für Bewegtbild nutze ich vor allem Seedance 2.5, Gemini Omni Flash, Minimax H3, Kling 3.0 und WAN 2.7.
Die Liste ist wahrscheinlich bereits veraltet, während Sie sie lesen. Wichtiger als die Namen ist das Prinzip: Legen Sie sich nicht auf ein Werkzeug fest. Bei wichtigen Motiven lasse ich dieselbe Idee von zwei oder drei Modellen parallel erzeugen und vergleiche das Ergebnis. Das kostet ein paar Minuten mehr, erspart mir aber manchmal einen halben Tag Nacharbeit.
Prompting: Der Fehler, den fast alle machen
Jetzt zum Kern – und hier weiche ich von dem ab, was in den meisten Anleitungen steht.
Der häufigste Fehler ist, den Prompt, also die Eingabe oder den Arbeitsauftrag, selbst zu schreiben. Ich schreibe nur noch die Idee auf und nenne das Modell, mit dem das Bild oder Video entstehen soll. Den eigentlichen Prompt baut daraus eine Sprach-KI wie ChatGPT oder Claude, und zwar in genau der Struktur, die dieses Modell erwartet. Von Hand hat das vor zwei Jahren noch funktioniert. Heute nicht mehr. Moderne Bild- und Videomodelle erwarten eine erhebliche Menge an Angaben (siehe Kasten „Was in einen Bild-Prompt gehört“). Fehlt eine davon, füllt das Modell die Lücke selbst – und zwar mit dem statistisch Naheliegendsten. So entstehen die generischen Bilder, die man inzwischen überall erkennt.
Ebenso wichtig ist die Reihenfolge. Dieselben Angaben in anderer Abfolge ergeben ein anderes Bild, weil die Modelle die ersten Elemente stärker gewichten.
Und jedes Modell erwartet eine andere Struktur. Ein Prompt, der bei Midjourney hervorragend funktioniert, liefert bei Seedream ein unbrauchbares Ergebnis, weil dort andere Parameter zählen.
Praxistipp: Prompts nicht schreiben, sondern bauen lassen
Ich habe die Struktur jedes KI-Modells als eigenen Skill in Claude hinterlegt, also als abrufbare Anleitung, die das Sprachmodell durch die nötigen Angaben führt und sie in der richtigen Reihenfolge zusammensetzt. Ich nenne das Zielmodell und die inhaltliche Idee, der Skill erzeugt daraus den fertigen Prompt in der passenden Syntax. Für die Referenzblätter, in denen alle Faktoren für eine Einstellung verbindlich festgehalten sind (siehe Abschnitt „Konsistenz“), gilt dasselbe: Auch dafür liegt eine Struktur bereit, die abfragt, was auf das Blatt gehört. Das ist der wirksamste Hebel im ganzen Prozess. Wer ohne solche Vorlagen arbeitet, verbringt die meiste Zeit damit, gegen die Syntax anzukämpfen, statt am Motiv zu arbeiten.
Zu Referenzbildern teile ich noch eine Beobachtung, die gegen die verbreitete Empfehlung in Prompting-Anleitungen läuft. Natürlich hänge ich Referenzen an den Prompt an, wenn ein bestimmtes Gerät oder eine bestimmte Person exakt getroffen werden muss. Oft ist es aber besser, ohne diese zu arbeiten, denn jede zusätzliche Referenz engt den Spielraum ein: Das Modell orientiert sich am Vorbild, statt eine eigene, womöglich bessere Lösung zu finden.
Was in einen Bild-Prompt gehört
Motiv und Handlung, Umgebung, Kameraposition und -perspektive, Brennweite, Lichtsituation und Tageszeit, Stil und Bildsprache, Bildformat.
Für Bewegtbild kommen Bewegungsrichtung, Kamerafahrt und Tempo hinzu. Eine Hauptbewegung pro Einstellung, nicht drei. Widersprüchliche Angaben, etwa eine Zoomfahrt und gleichzeitig ein statisches Stativ, führen zuverlässig zu Artefakten.
Konsistenz: Das eigentliche Problem bei mehreren Einstellungen
Ein Einzelbild bekommt fast jeder hin. Der Bruch kommt beim zweiten.
Sobald ein Beitrag mehrere Grafiken oder ein Video mehrere Einstellungen umfasst, muss alles zusammenpassen: dieselbe Figur, dasselbe Gerät, dieselbe Farbwelt, dasselbe Licht. Modelle haben kein Gedächtnis zwischen zwei Anfragen. Ohne Gegenmaßnahme sieht das Objekt in Einstellung zwei anders aus als in Einstellung eins und der Beitrag wirkt zusammengestückelt.
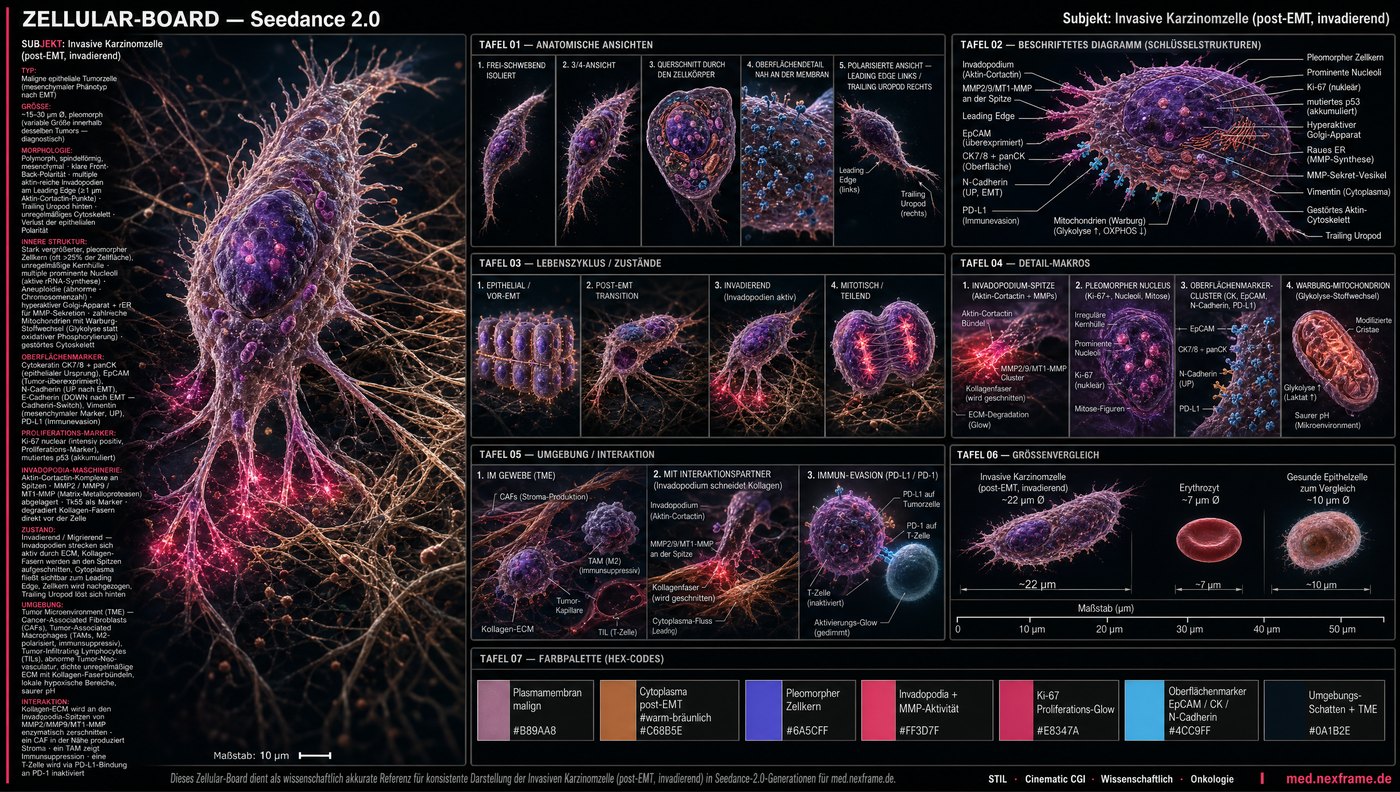
Die Lösung heißt im Produktionsjargon „Board“. Vor der eigentlichen Arbeit entsteht ein Referenzblatt, in dem alle Faktoren verbindlich festgehalten werden: die Figur oder das Objekt aus mehreren Perspektiven, Detailaufnahmen, Farbwerte, Lichtstimmungen, gegebenenfalls die Umgebung. Dieses Blatt dient anschließend als Anker für jede einzelne Einstellung.
Praxistipp: Erst das Board, dann die Bilder
Ein Board kostet Zeit, die man zunächst zu verlieren glaubt. Es rechnet sich aber ab der zweiten Einstellung. Für ein Projekt mit sechs wiederkehrenden Motiven habe ich zuerst eine Übersichtsdarstellung erzeugt, die alle sechs zusammen zeigt, samt Farbwelt und Lichtstimmung. Alle Einzelbilder wurden danach daraus abgeleitet. Ohne diesen Schritt hätte ich sechs Motive, die nicht zusammengehören.
Faktentreue ist Ihre Sorgfaltspflicht
Für publizierende Fachleute ist das der heikelste Punkt.
Generative Modelle erfinden Details, die zunächst plausibel aussehen, es aber nicht sind: eine Klappe an der falschen Stelle, ein Bauteil zu viel, eine erfundene Beschriftung. Im Fließtext fällt eine falsche Behauptung auf, weil man sie lesen und prüfen kann. Im Bild fällt sie nicht auf, weil das Bild als Ganzes überzeugend wirkt.
Behandeln Sie eine generierte Abbildung deshalb wie eine Quelle, die geprüft werden muss. Konkret: Lassen Sie das Motiv, bevor es erscheint, von jemandem begutachten, der das Fachgebiet beherrscht. Bei einer Illustratorin oder einem Illustrator haben Sie diese Prüfung implizit mitgekauft, weil sie ihr Fach kennen. Bei einem Modell kaufen Sie sie nicht mit.
Wo Genauigkeit unverzichtbar ist, gehen Sie den umgekehrten Weg: Fertigen Sie eine korrekte Skizze an und lassen Sie das Modell nur die Ausarbeitung übernehmen. Dann liefert es Gestaltung statt Inhalt.
KI-Kennzeichnung ist Pflicht
Seit dem 2. August 2026 greifen die Transparenzpflichten der europäischen KI-Verordnung (EU AI Act). Für Bild und Video gilt eine strengere Erwartung als für Text, weil generierte Aufnahmen als echt missverstanden werden können. Rechtliche Einzelheiten zu den KI-Kennzeichnungspflichten erfahren Sie in den beiden Podcast-Beiträgen von Andrea Dagmar Zimmermann in diesem Magazin.
Praktisch heißt es: Planen Sie die Kennzeichnung von Anfang an ein, nicht nachträglich. Eine Bildunterschrift, die den Ursprung nennt, kostet nichts und erspart Diskussionen.
Für welche Ressorts lohnen sich KI-generierte Visualisierungen?
Am größten ist der Gewinn dort, wo das Objekt der Berichterstattung unsichtbar oder unzugänglich ist. Medizin und Life Sciences, wo Mechanismen im Körper stattfinden. Technik und Ingenieurwesen, wo das Innere von Geräten oder Anlagen interessiert. Wissenschaft, wo es um Modelle und Prozesse geht. Wirtschaft, wenn Abläufe statt Zahlen erklärt werden sollen. Recht, wo Verfahrensabläufe transparent zu veranschaulichen sind.
Und die Gegenprobe, die genauso wichtig ist: Wo ein Foto existiert, nehmen Sie das Foto. Wo Zahlen die Aussage tragen, nehmen Sie ein Diagramm. Wo eine Tabelle genügt, nehmen Sie die Tabelle. Eine generierte Illustration, die nichts erklärt, ist Dekoration – und Dekoration erkennt Ihre Leserschaft inzwischen sofort.
Fazit
Die Kostenschwelle, die Fachredaktionen jahrzehntelang von guten Erklärgrafiken getrennt hat, ist gefallen. An ihre Stelle ist eine Kompetenzschwelle getreten. Die ist zwar niedriger, aber nicht null.
Wer einsteigen will, fängt mit Standbildern an, nicht mit Video. Wer mehr als eine Grafik braucht, baut zuerst ein Referenzblatt. Wer brauchbare Prompts will, schreibt sie nicht selbst, sondern lässt sie aus einer modellspezifischen Vorlage erzeugen. Und wer fachlich publiziert, prüft die Abbildung so sorgfältig wie einen Absatz Text.
Der Rest ist Übung. Mit zwei bis 24 Stunden für eine ordentliche Grafik ist das kein Nachmittagsprojekt, aber es ist etwas, das eine einzelne Person heute leisten kann. Vor drei Jahren war das nicht so.